性能剖析实践
概述
本文说明如何创建性能剖析任务、使用 profiler 采集,并查询和解读结果。功能与适用问题见持续性能剖析。
| 使用目标 | 阅读入口 |
|---|---|
| 完成一次远程 CPU 剖析 | 快速开始 |
| 在目标节点直接采集 | 命令行采集 |
| 选择输出格式并分析数据 | 结果 |
| 编程管理采集任务 | Profiling API |
| 查找参数默认值和限制 | 命令行参数 |
快速开始
示例基于仓库根目录下的 build/docker/docker-compose.yml,从零开始完成一次宿主机 CPU 性能剖析,并在 Grafana 中选择时间范围分析火焰图。
1. 启动服务
先按 Docker 部署准备 Linux 节点、Docker Compose 和 build/docker/.env。执行示例需要 curl 和 jq,目标节点应有待分析的 CPU 活动。
以下配置分别写入项目根目录的 huatuo-bamai.conf 和 huatuo-apiserver.conf,由 Compose 挂载。huatuo-bamai 负责写入剖析数据,huatuo-apiserver 负责查询;两者需连接同一 ES 索引。ES 密码应与 .env 的 ELASTIC_PASSWORD 一致。节点 token 在两份配置中保持一致,API token 用于后续请求。
Grafana 的 pyroscope.yaml 中,Pyroscope 和 Infinity 两个数据源需配置相同的 API token。
在 huatuo-bamai.conf 中配置:
[HTTPServer.Auth]
    BearerToken = "REPLACE_WITH_NODE_TOKEN"

[Storage]
    [Storage.Elasticsearch]
        Address = "http://127.0.0.1:9200"
        Index = "huatuo_bamai"
        Username = "elastic"
        Password = "huatuo-bamai"
在 huatuo-apiserver.conf 中配置:
[Agent.Auth]
    BearerToken = "REPLACE_WITH_NODE_TOKEN"

[Elasticsearch]
    Address = "http://127.0.0.1:9200"
    Username = "elastic"
    Password = "huatuo-bamai"
    Index = "huatuo_bamai"

[Auth]
    [[Auth.Users]]
        ID = "administrator"
        BearerToken = "REPLACE_WITH_RANDOM_HEX"
        Admin = true
在仓库根目录执行:
docker compose --project-directory ./build/docker up
此命令以前台方式运行,后续操作在另一个终端执行。
启动后运行的组件及作用:
| 服务 | 作用 | 默认端口 |
|---|---|---|
huatuo-bamai |
采集 Agent,执行 profiler 采样 | 19704 |
huatuo-apiserver |
API 入口,创建任务、下发、查询火焰图 | 12740 |
elasticsearch |
存储 profile 数据(index:huatuo_bamai) |
9200 |
grafana |
火焰图面板展示 | 3000 |
2. 检查服务
确认节点和 API 服务可访问:
curl -fsS http://localhost:19704/version | jq .data.name
curl -fsS http://localhost:12740/version | jq .data.name
curl -fsS -u elastic:huatuo-bamai http://localhost:9200/ | jq .cluster_name
前两项应分别返回 huatuo-bamai 和 huatuo-apiserver,第三项应返回 ES 集群名。这只确认服务可访问,实际采集结果在第 4 步验证。
设置环境变量便于后续调用:
API_BASE="http://127.0.0.1:12740"
API_TOKEN="REPLACE_WITH_RANDOM_HEX"
3. 创建任务
以 c 语言(原生,覆盖 C/C++/Go 等)为例,对宿主机整体采样 30 秒:
# 使用 huatuo-bamai 上报的节点主机名
TARGET_HOST="REPLACE_WITH_NODE_HOSTNAME"

JOB_ID=$(curl -fsS -X POST \
  -H "Authorization: Bearer ${API_TOKEN}" \
  -H "Content-Type: application/json" \
  -d "{
    \"type\": \"cpu\",
    \"language\": \"c\",
    \"mode\": \"oncpu\",
    \"scope\": \"host\",
    \"duration_seconds\": 30,
    \"hostname\": \"${TARGET_HOST}\"
  }" \
  "${API_BASE}/v1/profiling" | jq -er .data.request_id)

echo "Job ID: $JOB_ID"
4. 验证结果
使用上一步返回的 JOB_ID 查询状态。采集时长不包含排队和结果提交时间,应以任务状态为准:
curl -fsS -H "Authorization: Bearer ${API_TOKEN}" \
  "${API_BASE}/v1/profiling/${JOB_ID}" | jq '.data | {status, terminal, result_url}'
正常结束后应看到 status=terminal、terminal.outcome=completed。若仍为 pending 或 running,稍后重查;失败时根据 terminal.reason 和 terminal.message 排查节点及采集工具。
确认任务结束后,读取本次任务的一页原始结果:
curl -fsS -H "Authorization: Bearer ${API_TOKEN}" \
  "${API_BASE}/v1/profiling/${JOB_ID}/raw?limit=1&offset=0" | jq .data
成功响应表示结果已发布;items 可以为空,例如采集期间没有有效样本。不要用整个索引的文档数判断本次任务是否成功。结果错误码和分页规则见 API 结果查询。
5. 查看火焰图
示例是对本机进行剖析,打开统一的 Continuous Profiling 面板:
- 地址:http://localhost:3000/d/continuous-profiling (根据实际环境地址替换
localhost:3000) - 账号/密码:
admin / admin(首次登录按提示修改密码)
操作步骤:
- 右上角选择时间范围,确保覆盖采样时间段
- 变量栏依次选择 Region、目标节点
hostname、范围host和本次 Task ID,并选择type为process_cpu:cpu:nanoseconds:cpu:nanoseconds - 查看所选任务和时间范围内的聚合调用栈,使用 Focus block 聚焦目标栈帧
- 选择 Both 同时展示火焰图和函数统计表
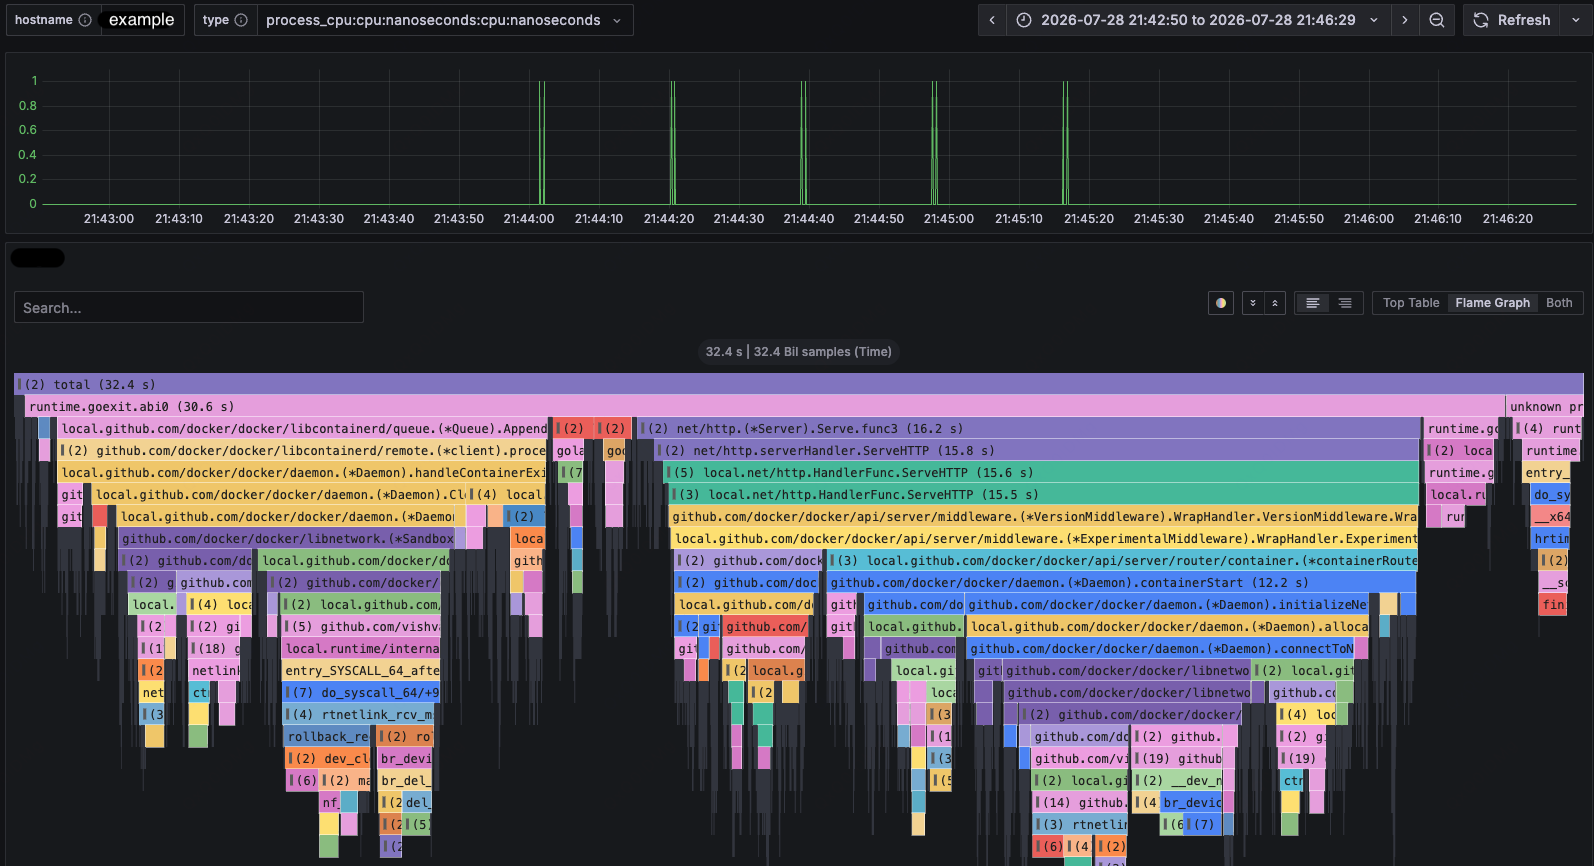
本地试用结束后,可在仓库根目录运行 docker compose --project-directory ./build/docker down 停止并移除本次 Compose 服务。
命令行采集
profiler 可独立采集并输出本地结果,无需部署 API 服务、Elasticsearch 或 Grafana。以下 PID、容器 ID 和工具路径均为占位值,执行前替换为实际目标。
运行条件
在仓库根目录构建完整产物:
make build
生成的命令位于 _output/bin/profiler。原生采集依赖 Linux eBPF、perf event 和仓库构建出的 BPF 对象,通常需要 root 权限,并要求 kernel.perf_event_paranoid 允许采样。Java 需要 async-profiler,--tool-path 指向统一工具根目录,其中包含 bin/asprof 和 lib/libasyncProfiler.so。Python 使用同一根目录下的 py-spy。
查看当前版本的完整帮助:
_output/bin/profiler --help
命令的基本结构如下:
sudo _output/bin/profiler \
  --type <cpu|memory> \
  --language <c|c++|go|java|python> \
  --pid <pid> \
  --duration 30 \
  --aggr-interval 10 \
  --output-format flamegraph \
  --output-path ./profiles/
--type 和 --language 为必填参数。Java、Python 和原生内存采集必须在 --pid 与 --container-id 中指定且仅指定一个目标;原生 CPU 采集未指定目标时可进行宿主机级采样。
容器目标还需要可访问的 huatuo-bamai 节点接口,用于解析容器元数据;地址由 --huatuo-api-address 指定。
C、C++ 和 Go
C、C++ 和 Go 均使用原生 eBPF 采集器,命令只需替换 --language。on-CPU 模式按采样频率将样本折算为 CPU 时间,同时包含可解析的用户态栈和内核态栈。
sudo _output/bin/profiler \
  --type cpu \
  --language go \
  --pid 12345 \
  --duration 30 \
  --aggr-interval 10 \
  --freq 99 \
  --output-format flamegraph \
  --output-path ./profiles/go-cpu/
如需包含同一进程的工作线程,增加 --thread-group。如需限定 CPU,增加 --cpuid 2,4-7。原生 CPU 也支持容器和宿主机级采样:
原生 on-CPU 采集优先使用硬件 CPU cycle event;硬件 PMU 不可用时回退软件
CPU clock。两种采样源下 --freq 均表示每秒采样次数。若软件时钟回退会掩盖
IRQ 关闭期间的 CPU 时间,可指定 --require-hardware-pmu。
# 采集指定容器
sudo _output/bin/profiler \
  --type cpu --language c --container-id <container-id> \
  --duration 30 --aggr-interval 10 \
  --output-format collapsed --output-path ./profiles/container/

# 不指定 PID 或容器,采集宿主机
sudo _output/bin/profiler \
  --type cpu --language c \
  --duration 30 --aggr-interval 10 \
  --output-format flamegraph --output-path ./profiles/host/
如需把线程离开 CPU 的时间归因到触发切出的调用路径,使用 off-CPU 模式:
sudo _output/bin/profiler \
  --type cpu --language go --pid 12345 --thread-group \
  --cpu-mode offcpu --offcpu-phase all \
  --cpuid 2,4-7 \
  --offcpu-min-duration-us 1000 \
  --duration 30 --aggr-interval 10 \
  --output-format flamegraph --output-path ./profiles/go-offcpu/
off-CPU 是事件驱动采集,因此不使用 --freq。指定 --cpuid 时,仅记录任务从目标 CPU 切出后开始的区间;后续在其他 CPU 唤醒或切入不会改变该归属。火焰图直接以纳秒为数值,并增加 off-CPU blocked、scheduling delay (preempted)、scheduling delay (yielded) 等根节点。all 阶段同时累计阻塞与 runqueue 等待时间,但仍按这些根节点分开显示。
原生内存支持以下维度:
--memory-mode |
统计内容 | 适用问题 |
|---|---|---|
virtual_alloc |
虚拟地址空间分配量及其调用栈 | mmap 等虚拟内存申请过多、地址空间增长 |
physical_alloc |
采集窗口内新分配的物理内存量 | 缺页触发的物理页分配热点、分配速率分析 |
physical_usage |
本次采样跟踪的物理页存活字节数 | 按分配栈定位采样存活页,不代表完整 RSS |
physical_usage 的跨周期栈匹配、页释放识别和停止时的数据收集仍待验证,结果不能视为精确物理驻留量。使用前阅读物理内存存活量中的限制。
sudo _output/bin/profiler \
  --type memory \
  --language c++ \
  --memory-mode physical_usage \
  --pid 12345 \
  --thread-group \
  --physical-memory-probability 100 \
  --duration 30 \
  --aggr-interval 10 \
  --output-format flamegraph \
  --output-path ./profiles/native-memory/
--physical-memory-probability 仅适用于 physical_alloc 和 physical_usage。降低该值可减少高频内存事件的处理量。physical_alloc 按采样概率估算分配量;physical_usage 只统计采样跟踪的页,不按概率倒数放大,也不包含采集前分配的页。
本地采集完成后,按验证本地结果检查输出。
Java
Java CPU 采集依赖 async-profiler。单 PID、容器和多 PID 均可使用:
_output/bin/profiler \
  --type cpu \
  --language java \
  --pid 12345,12346 \
  --tool-path /opt/huatuo/tools \
  --max-concurrent-procs 2 \
  --duration 30 \
  --aggr-interval 10 \
  --freq 99 \
  --output-format flamegraph \
  --output-path ./profiles/java-cpu/
Java 栈中的类名使用点分隔(例如 java.lang.Thread.run)。分配对象类型不保留 TLAB 内外的颜色标记;同一调用栈中的同类型对象按字节数合并。真正的内核帧仍使用 _[k] 后缀。
Java 内存支持两个维度:
--memory-mode |
统计内容 | 适用问题 |
|---|---|---|
object_alloc |
采集窗口内的对象分配及分配调用栈 | 高分配速率、短命对象和 GC 压力来源 |
object_usage |
存活对象及其分配调用栈 | 长生命周期对象、堆占用来源和疑似内存泄漏 |
_output/bin/profiler \
  --type memory \
  --language java \
  --memory-mode object_usage \
  --pid 12345 \
  --tool-path /opt/huatuo/tools \
  --duration 30 \
  --aggr-interval 10 \
  --output-format flamegraph \
  --output-path ./profiles/java-memory/
使用容器 ID 时,将 --pid 替换为 --container-id <container-id>。如果容器内存在多个候选进程,可通过 --binary-match-path 指定目标可执行文件路径。
本地采集完成后,按验证本地结果检查输出。
Python
Python 当前仅支持 CPU 观测。--aggr-interval 必须与 --duration 相等,即一次采集只生成一个聚合窗口。--tool-path 指向包含 py-spy 的统一工具根目录。
_output/bin/profiler \
  --type cpu \
  --language python \
  --pid 12345,12346 \
  --tool-path /opt/huatuo/tools \
  --max-concurrent-procs 2 \
  --duration 30 \
  --aggr-interval 30 \
  --freq 99 \
  --output-format flamegraph \
  --output-path ./profiles/python-cpu/
采集结束后,按验证本地结果检查输出。
验证本地结果
采集前确认目标进程仍在运行,并在采集期间执行需要分析的请求或操作。为本次采集使用独立输出目录,避免将旧文件误认为新结果。
- 确认命令成功结束,并检查是否有采集、输出或丢样告警。
- 查看
--output-path指定的目录。以上 Go CPU 示例应在收到有效样本并完成采集后生成profiles/go-cpu/flamegraph_<Unix 时间戳>.svg。其他示例按各自输出目录检查。 - 在浏览器中打开本次 SVG,搜索预期业务函数,查看调用栈和数值。CPU 和等待时间使用纳秒,内存使用字节;详细解释见火焰图。
若没有文件、结果为空或缺少目标栈,先核对 PID、容器、线程和 CPU 过滤条件,再确认采集期间有目标活动,并检查权限、工具依赖和错误日志。
从未收到样本时可能不生成展示文件;文件存在也不能单独证明任务成功或数据完整。物理内存样本抵消后的空结果见物理内存存活量。
结果
输出格式
| 格式 | 生成内容 | 选择建议 |
|---|---|---|
collapsed |
perf_<Unix 时间戳>.folded;每行是以分号分隔的调用栈及末尾计数 |
用于脚本检索、结果比较,或交给其他火焰图工具二次渲染 |
flamegraph |
flamegraph_<Unix 时间戳>.svg;内嵌交互脚本的 SVG |
推荐用于人工分析,可在浏览器中搜索、缩放和查看栈帧数值 |
svg |
与 flamegraph 相同的交互式 SVG |
兼容显式要求 SVG 的调用方;当前实现与 flamegraph 等价 |
json |
每个采集窗口一行 JSON,流式采集可输出多行 | 保留窗口、样本标签和有符号值 |
remote-store |
不生成本地火焰图,通过 Unix socket 上传 pprof 兼容数据 | 接入 HUATUO 存储链路时使用,不适合离线查看 |
火焰图
火焰图从下到上表示调用方向,矩形宽度表示该调用栈在当前观测维度中的累计值。不同类型的宽度含义不同:on-CPU 表示采样折算的 CPU 时间,off-CPU 表示阻塞或调度等待时间;内存模式表示相应的虚拟分配、物理分配、采样跟踪的物理页存活量、Java 对象分配或存活对象量。横向位置不表示时间先后。
折叠栈示例:
main;handleRequest;parsePayload 428
main;handleRequest;writeResponse 172
需要保留原始数据并支持后续使用不同配色或过滤规则重新渲染时,选择 collapsed。只需直接定位热点时,选择 flamegraph。remote-store 依赖 HUATUO toolstream Unix socket,要求提供非空的 --task-id,独立离线使用时不应选择该格式。
采集窗口
--duration 控制总采集时长,--aggr-interval 控制聚合周期。原生 CPU、内存和 Java 采集按周期处理数据;Python 在采集结束后输出一次。窗口时间描述接收和聚合区间,不是精确的逐样本执行时间。
调用栈按用户栈、内核栈和完整标签组聚合。CPU 时间和等待时间使用纳秒,内存使用字节。comm 仅表示进程命令名,Java、Python 入口分别保存在 java_entry、python_entry 标签中。
collapsed、flamegraph 和 svg 在采集成功结束后生成最终聚合结果;json 保留各窗口及有符号值。展示格式会将每个样本的负累计值归零并记录警告。标签已保存不代表查询接口支持任意标签索引或过滤。
物理内存存活量
physical_usage 表示本次采集跟踪到的物理页存活字节数,不包含采集前分配的页,也不按采样概率倒数放大,因此不等同于进程完整 RSS。
远端类型为 memory:physical_usage:bytes:space:bytes。每个输出周期保存当前快照,持续时间为零。查询必须指定单个 Task ID,并只取时间范围内的最新快照;不得将多个快照相加,也不应回退到旧的非零结果。Grafana 使用 Task ID 输入框限定任务。
本地 SVG 和折叠栈输出最终累计结果;JSON 保留各周期的有符号增量。样本全部抵消时仍生成有效空结果,从未收到样本则不创建本地展示文件。
正常停止时会读取剩余缓冲数据,但真实采样链路的尾部完整性仍待验证。跨周期栈匹配、实际物理页释放及部分释放识别仍待验证和完善,当前结果不能视为精确物理驻留量。高基数采集的内存占用也会随不同样本数量增长。
任务完成
命令行达到采集时长或收到 SIGINT(Ctrl+C)后正常收尾:停止采集,读取并投递尾部样本,排空队列后提交结果。收尾共享 30 秒处理预算;超时、其他取消信号或采集、输出错误会阻止结果提交。资源清理仍会执行,外部工具清理有独立超时。
API 主动停止会中止任务,不发布结果完成标记,结果规则见 API 停止任务。输出不提供事务回滚,失败前已经写出的窗口或本地数据可能保留。
远端结果经 remote-store 提交后才具有完成标记。任务原始结果查询依赖该标记;通用火焰图查询不保证排除所有未完成窗口,不能据图表出现数据就认定任务成功。升级远端采集链路时,应先升级接收端再升级发送端;当前统一窗口使用业务协议版本 3,旧版本 1/2 仅兼容旧的完整 pprof 数据。
丢样
采集丢样记录在 profile_data.metrics.dropped_samples 的 collection 分类。用户态队列满时等待聚合消费,处理上下文取消时终止等待,不会静默丢弃;aggregation_queue 仅用于历史数据兼容。physical_usage 遇到明确丢样时失败,其他类型可保留丢样统计。取消不保证导出最终统计,因此空结果或缺少丢样字段不能单独证明没有丢样。
Profiling API
任务创建、查询、结果分页和停止规则见 Profiling API。
命令行参数
参数默认值、范围和适用模式见 profiler 命令行参数。
集成测试
需要可重复的工作负载与调用栈断言时,见剖析集成测试。